Problèmes relevés concernant des messages incorrectement importés de l'ancienne liste GUT

J’ouvre ce fil de discussion pour lister des problèmes rencontrés sur des messages importés de l’ancienne liste.

Ce sujet, technique et concernant un sujet qui ne traite pas directement de LaTeX, mais des rouages du forum, pourrait ne pas intéresser tous les lecteurs.

À droite de ce message, lorsqu’il est lu sur le forum web, vous pouvez voir une cloche et en cliquant dessus, choisir de mettre ce sujet en sourdine s’il ne vous intéresse pas :
Cette précision étant faite, voici le problème rencontré :

Point numéro 1

Sur le sujet https://forum.gutenberg-asso.fr/t/probleme-avec-tkz/2522, le premier message comporte du code dans un bloc, mais le code tel qu’il est importé comporte un certain nombre de manques.

Voici comment se présente ce mail du 15 septembre 2022 à 14h43 (afin que vous puissiez le retrouver dans vos archives), je considère la fin du bloc de code, jusqu’au dernier \end{scope} :
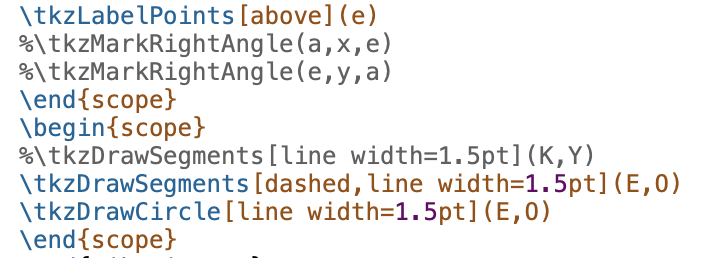
Voici maintenant comment cette même partie de code est affichée actuellement dans le forum :
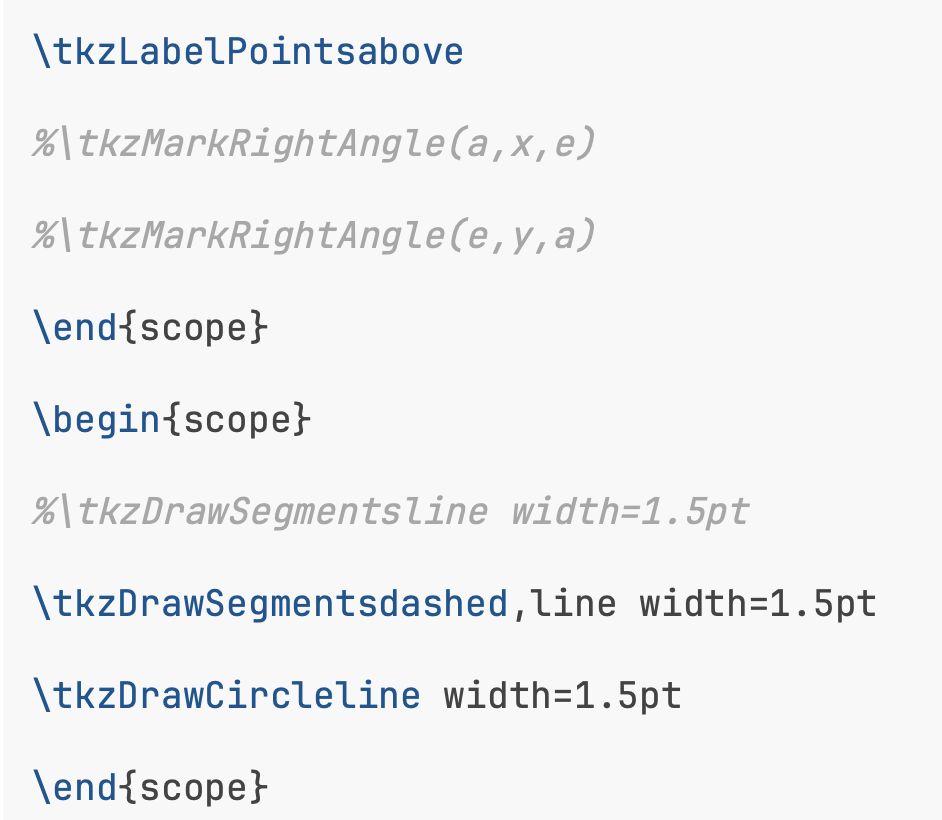
Sur la première ligne, le code d’origine

\tkzLabelPoints[above](e)

est devenu

\tkzLabelPointsabove (les crochets ont disparus et ce qui est entre parenthèses, parenthèses incluses, a également disparu).

Sur l’avant-dernière ligne du code dans cet extrait, le code d’origine :

\tkzDrawCircle[line width=1.5pt](E,O)

est devenu

\tkzDrawCircleline width=1.5pt

(la ligne précédente est aussi concernée par le problème, de même que d’autres lignes).

Je ne sais pas s’il est possible, sinon de reprendre les importations qui se sont mal déroulés, du moins d’identifier la caractéristique des messages où cette importation s’est mal faite afin de pouvoir réaliser une correction manuelle sur ces messages s’ils ne sont pas trop nombreux.

Point numéro 2

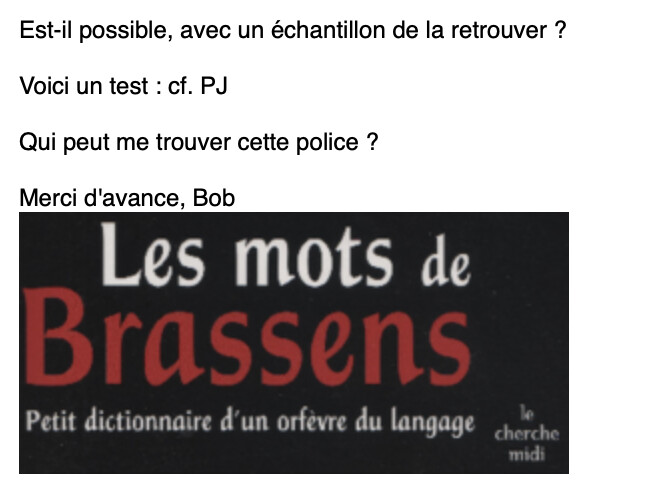
Sur le message https://forum.gutenberg-asso.fr/t/ou-est-la-police/2783, l’importation n’a pas inclu la pièce-jointe :
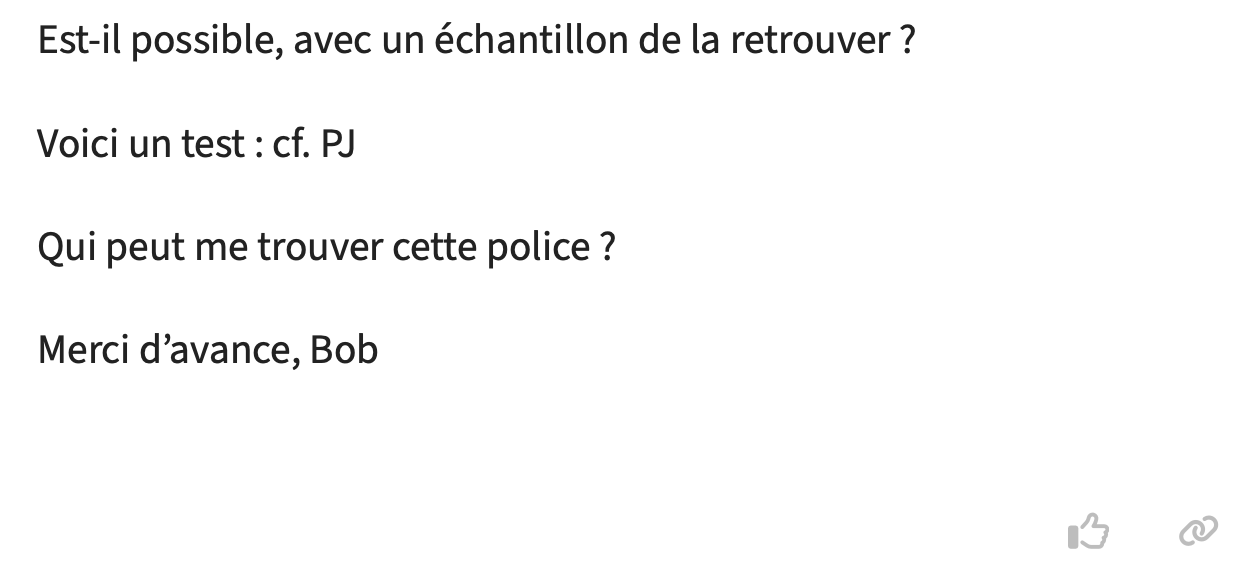
Le mail du 16 juillet 2025 à 21h26 comportait la pièce-jointe :
Point numéro 3

Beamer emploie une syntaxe utilisant les caractères < et >. Si le code n’est pas manuellement placé dans un bloc de code, Discourse croit avoir affaire à une balise HTML et masque l’affichage de cette « balise ».

La correction a depuis été faite sur https://forum.gutenberg-asso.fr/t/beamer-emph/2812, mais à l’origine, le code s’affichait ainsi :
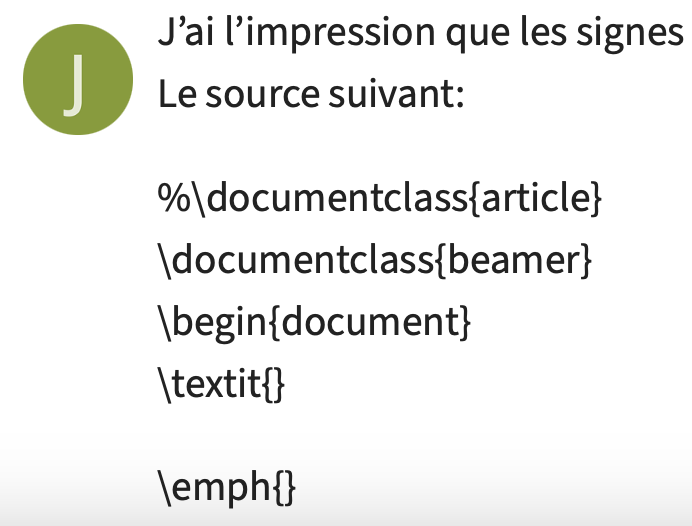
(notez \textit{} et \emph{}) alors que le message d’origine était le suivant :
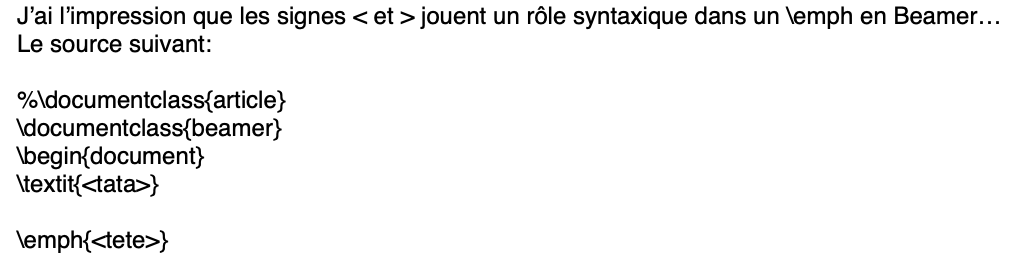
Ici ce n’est pas vraiment un problème d’importation, mais il faudrait pouvoir identifier tous les messages comportant du texte entre < et > pour pouvoir faire la correction manuellement sur ces messages.

1 « J'aime »

Point numéro 4

Lors de l’importation des messages, leur mise en forme (gras dans le cas présent) a été perdue :

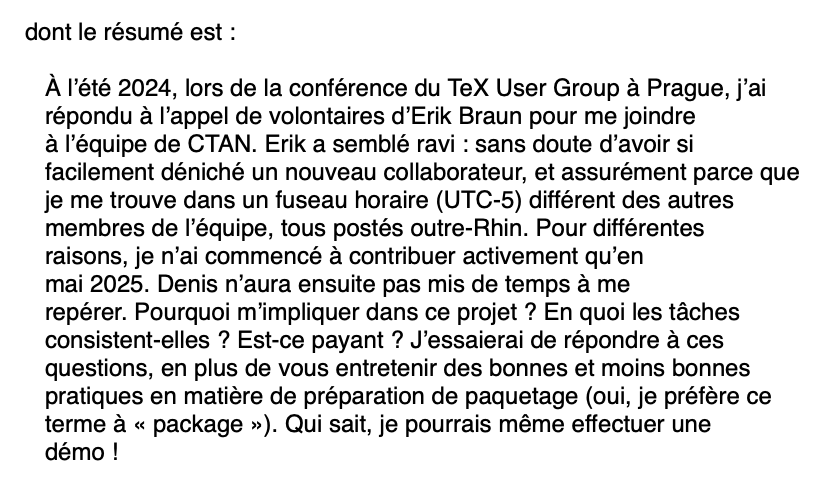
Le message d’origine :

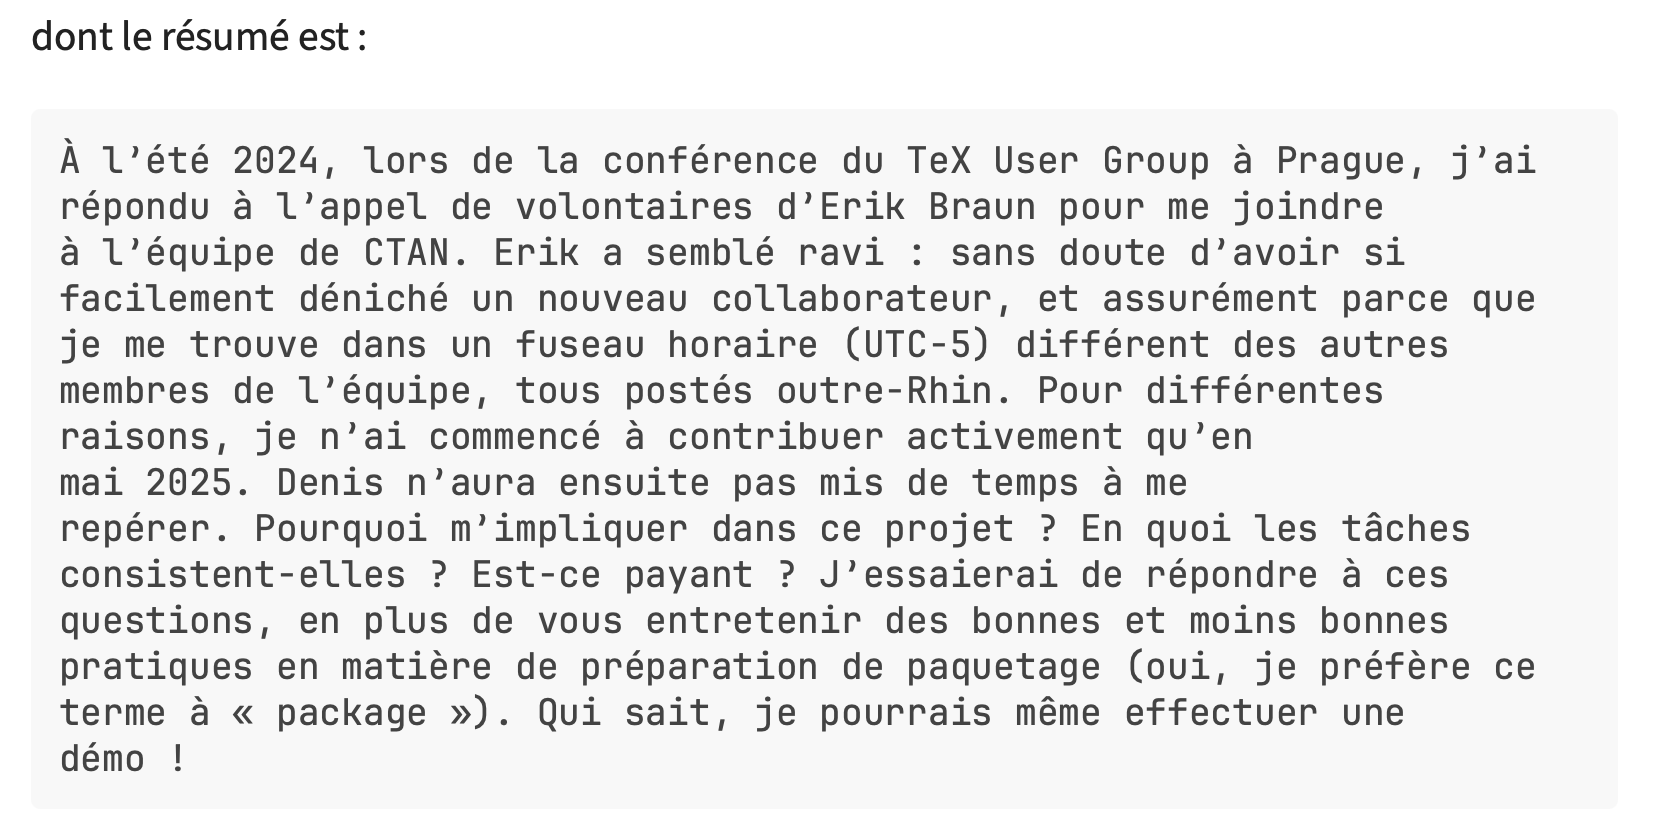
Le message apparaissant sur le forum (https://forum.gutenberg-asso.fr/t/interpretation/2651/13) :

Sur ce même message mail, la pièce jointe était incluse :

mais sur le forum :

(la ligne suivante du message montre que je ne me suis pas relu, écrivant « avec » au lieu de « avant » ; il y a d’autres fautes grossières de ma part dans ce fil de discussion, désolé, le moment était compliqué pour moi).

La recherche avec l’outil du forum sur le caractère «  » ne donne aucun résultat intéressant (trop de résultats parasites). Je ne sais pas s’il sera possible d’identifier tous les messages où les pièces jointes ont été omises.

Merci bien @quark_67 pour cet état des lieux ! Je pense que @dlukazo pourra nous dire s’il est encore possible de traiter à coups de regex le contenu actuel du site (quitte à le mettre en maintenance le temps de réimporter son contenu affiné).

Les points que tu soulèves dans le 1er message et celui des pièces jointes me paraissent nécessiter en effet un traitement ; celui du gras qui aura été perdu me semble en revanche beaucoup moins critique.

Lors d’une discussion en privé, @quark_67 avait aussi soulevé le lièvre intéressant suivant. Les signatures de mail de la forme :

⟨fin du message⟩
-- 
⟨signataire⟩

donnent :

⟨fin du message⟩

⟨signataire⟩

et ce, du fait que, en Markdown, -- sous un texte en fait un titre de section.

J’ai cherché mais n’ai pas trouvé comment mettre à 3 le nombre minimal de - consécutifs pour que ce qui se trouve sur la ligne précédente soit considéré comme un titre de section. Si ce n’est pas possible, on pourrait vouloir chercher les messages contenant -- mais une recherche sur ces seuls caractères (car non alphabétiques ?) ne donne rien. En revanche, il est possible de rechercher sur des ⟨caractères⟩ au moyen de la syntaxe p{⟨caractères⟩}, par exemple p{-- }.

Daniel nous a dit qu’on ne pouvait plus refaire un import dès lors que des comptes des archives ont été fusionnés avec des comptes d’utilisateurs ; d’autre part, cela supprimerait le travail manuel d’anonymisation déjà accompli. Concernant le parser Markdown, je crois qu’on a vu qu’on ne peut pas le modifier ; s’il en va autrement, j’ai du l’écrire dans une autre discussion car je me souviens qu’on en a déjà parlé et que j’ai cherché.

On peut donc corriger certains messages à la main, mais dans ce cas, il faudrait signaler des discussions particulièrement dignes d’intérêt, que nous pourrions retravailler et reposter ensuite dans la catégorie correspondante.

Désolé pour ma moindre implication ces derniers temps : je consulte ma messagerie et je réponds parfois vite fait, mais je ne peux pas travailler sur le forum en ce moment.

Daniel nous a dit qu’on ne pouvait plus refaire un import dès lors que des comptes des archives ont été fusionnés avec des comptes d’utilisateurs ; d’autre part, cela supprimerait le travail manuel d’anonymisation déjà accompli.

Dans mon esprit, on retravaillerait, non pas les archives de gut@ens.fr, mais le contenu actuel du forum.

Concernant le parser Markdown, je crois qu’on a vu qu’on ne peut pas le modifier ; s’il en va autrement, j’ai du l’écrire dans une autre discussion car je me souviens qu’on en a déjà parlé et que j’ai cherché.

OK.

On peut donc corriger certains messages à la main, mais dans ce cas, il faudrait signaler des discussions particulièrement dignes d’intérêt, que nous pourrions retravailler et reposter ensuite dans la catégorie correspondante.

Yep.

Désolé pour ma moindre implication ces derniers temps : je consulte ma messagerie et je réponds parfois vite fait, mais je ne peux pas travailler sur le forum en ce moment.

Pas de souci ! :slight_smile:

Bonjour, je vais répondre point par point à ces remarques pertinentes sur la reprise des archives.

Vous faîtes bien d’indiquer la date et l’heure du mail mais j’ai gardé le lien entre le mail original et l’identifiant du sujet ou de la réponse dans le forum.

Comme l’a dit @bdumont, il est quasi impossible de relancer un chargement partiel et encore plus total maintenant que nous avons de “vrais(e)s” comptes. Cela demanderait un gros travail de synchronisation entre les comptes de reprise en les bons - pour ceux qui se sont inscrits.

1) Perte de crochets et de parenthèses Je ne comprends pas pourquoi ils ont été supprimés car ils sont bien dans le body du mail. J’ai vérifié mon code et je ne fais aucun traitement sur les crochets ou les parenthèses. D’autant plus surprenant que les crochets sont bien présents ailleurs dans le code.

Je referai la publication manuellement dans un autre environnement pour identifier l’origine : Discourse ou mon code.

2) Absence des pièces jointes Leur reprise était impossible car elles n’étaient pas livrées avec les mails au format .eml

3) Syntaxe beamer et “< ou >” Sauf à faire une analyse de contenu, il me semble difficile d’identifier un bloc de code latex dans un fichier texte. Les mails reçus sont au format .eml donc en format texte. Les extraits de code ne sont pas tous des sources complets.

Je pourrais faire une recherche par expression régulière des publications. On verra si il y a beaucoup de bruit.

Je propose que ceux qui identifient ce problème dans des publications le signalent aux administrateurs pour que la modification soit éventuellement faite.

4) Perte de la mise en forme Les mails reçus sont au format .eml donc en format texte brut, aucune mise en forme ne se trouve dans les fichiers source de la reprise. Et cela ne pourra pas être repris.

Pour conclure, il y a peu de points qui peuvent être résolus et encore moins automatiquement.

OK mais serait-il possible de retravailler, non pas les archives de gut@ens.fr, mais le contenu actuel du forum ?

Ah…

Je lis sur https://fr.wikihow.com/ouvrir-des-fichiers-EML que le formatage HTML serait préservé dans le format eml.

Sur macOS, le logiciel Mail stocke les courriels dans un format nommé emlx. Il s’agit d’un format texte, et pas d’un format binaire. Mais les pièces jointes sont dans un dossier à part, et il aurait fallu faire le lien.

Bref, il ne reste qu’à reconstituer ce qui peut l’être.

Le re-traitement des publications sur le forum lui-même demandera aussi un travail sur la base de données elle-même. Mais si pour l’obfuscation des numéros de téléphone ou des adresses mail l’expression régulière était précise, ce ne sera pas le cas pour les balises “<” et “>”. Il risque d’y avoir des modifications contre-productives. Et encore moins pour récupérer les crochets et parenthèses dans des extraits de code latex. Je ne me lancerai pas dans cette aventure.

Oui, mais comme les problèmes consistent généralement en du contenu qui a disparu, ça ne peut se faire qu’à la main par l’interface en ligne, d’où ma proposition de signaler les discussions jugées intéressantes. Et j’ajouterais : en fournissant une copie du courriel originel, car les modérateurs n’ont pas un accès direct aux archives, et de toute manière ça nous gagne du temps.

Je vais clore le débat, l’administrateur de la liste nous a fourni les archives au format texte brut. Nous n’étions pas maître de la constitution de ces archives. Avait-il la possibilité de faire autrement ? Je n’en sais rien et même si… reprendre automatiquement de nouvelles archives pour les ingérer dans le forum est un travail à risque.

Le mieux est l’ennemi du bien !

Point numéro 5

Lorsque dans l’ancienne liste, une mise en avant était faite en débutant chaque ligne d’un texte par deux caractères espace :

ces deux caractères au début d’un bloc de texte sont interprétés comme étant la syntaxe d’un bloc de code, par Markdown. Ce qui donne (cf. https://forum.gutenberg-asso.fr/t/exposes-mensuels-jeudi-9-octobre-a-20h-integrer-l-equipe-de-du-ce-si-tan-ne-par-vincent-goulet/2806) :

La syntaxe alternative, consistant à encadrer le bloc de code par ce qui ressemblerait à un environnement LaTeX, à savoir dans le cas de Markdown placer ``` sur la ligne précédant et suivant le bloc de code, n’engendre pas ce problème. Mais lors de l’importation, les deux espaces devant chaque lignes ont été conservés.

Dans le cas présent, la solution est de remplacer chaque (deux espaces) devant chaque ligne par > (en mode Markdown).

Là encore la difficulté va surtout être de pouvoir trouver les messages comportant ces blocs de texte mis en forme ainsi.

Peut-être que je m’y prends mal, mais cela ne fonctionne pas chez moi. Où est-ce documenté ?

J’ai trouvé ça en farfouillant sur meta.discourse.org, mais je ne retrouve malheureusement plus le lien.

Point numéro 6

L’affichage des URLs des messages importés de l’ancienne liste peut ne pas être optimale dans certains cas.

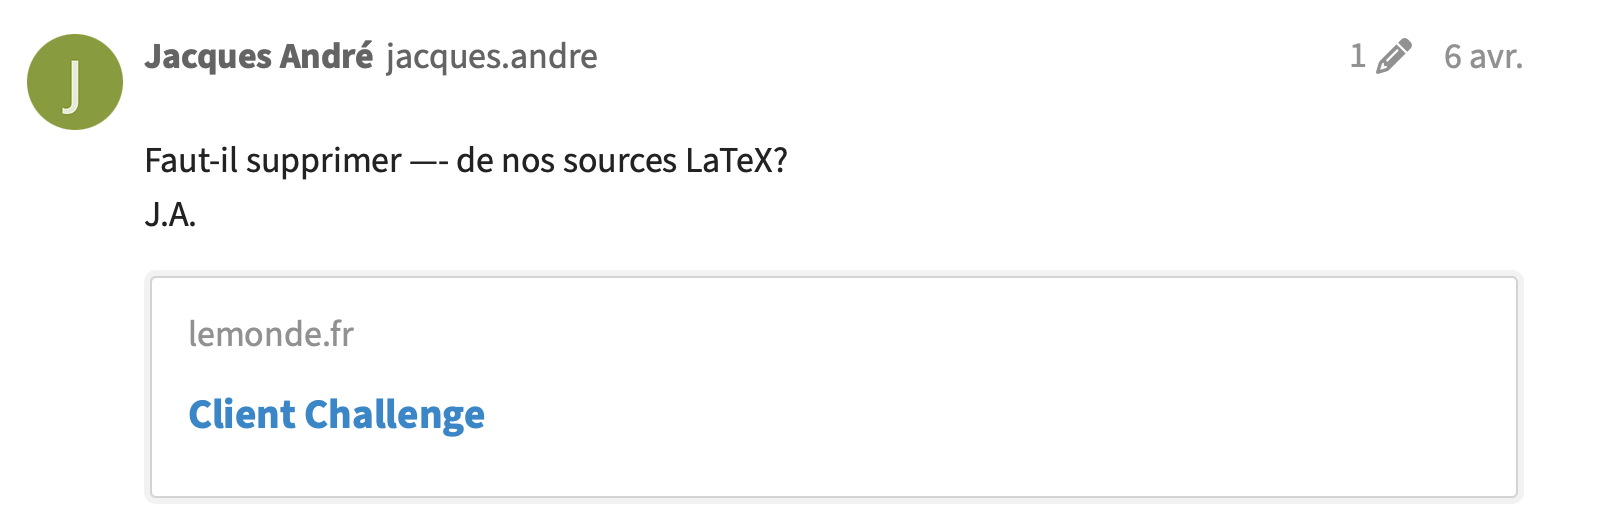
Malheureusement, je n’ai jamais reçu par mail le message d’origine de Jacques (même pas classé incorrectement dans les SPAMS).

Mais comme il a été cité par Thomas, on voit comment il était affiché :

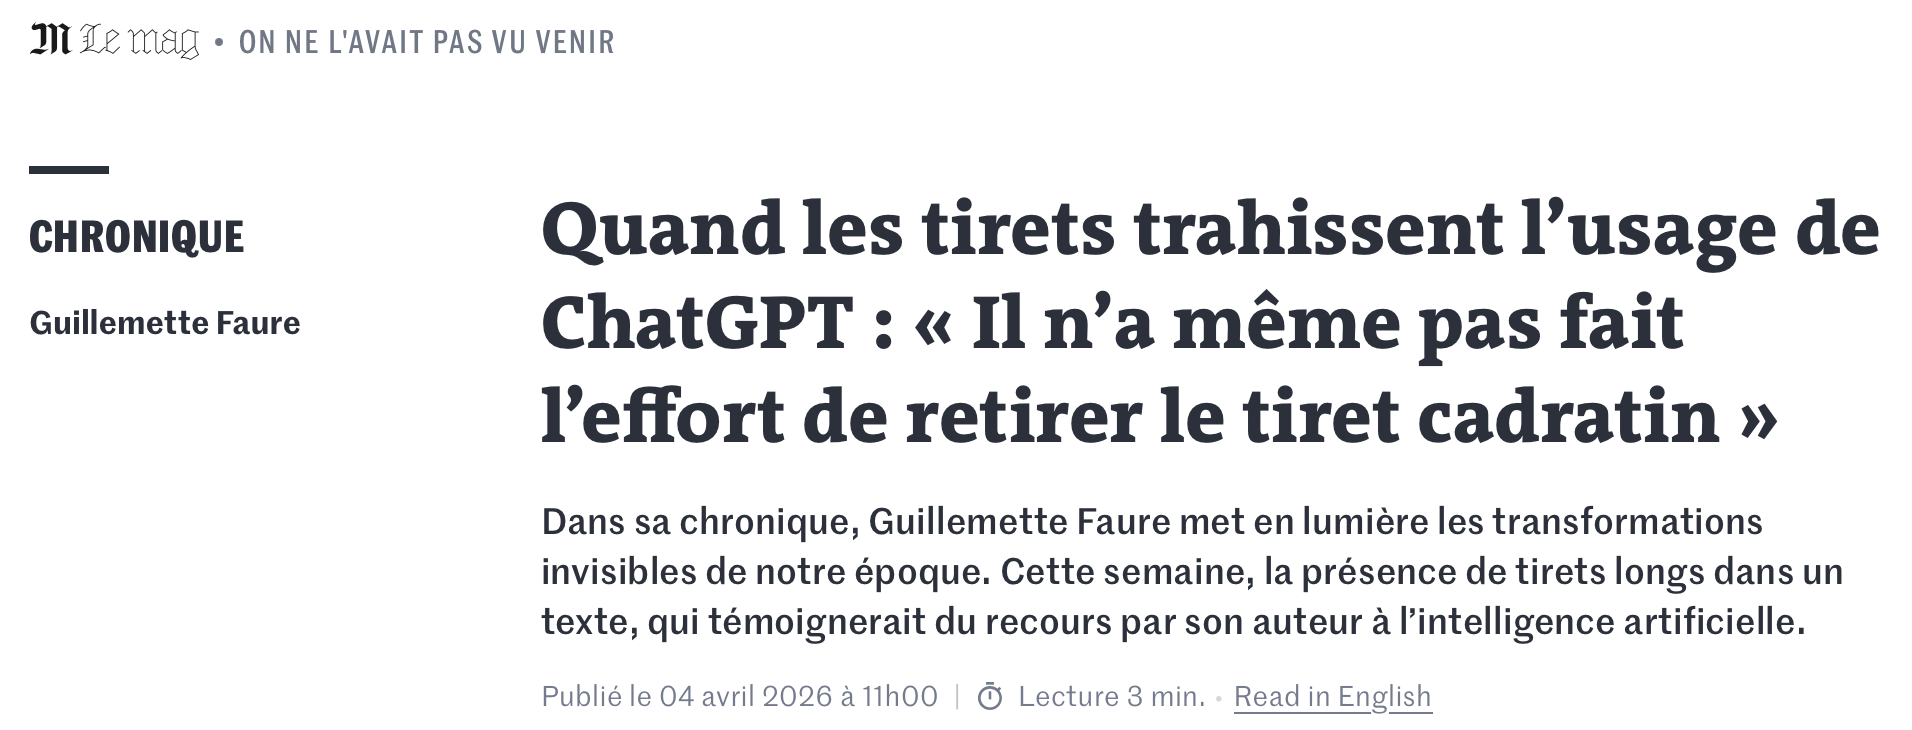
Le problème est le suivant : le moteur du forum produit une prévisualisation du contenu de la page web lorsque l’URL est simplement tapée au fil du texte. Mais ici la prévisualisation est totalement fausse (« Client Challenge » ? Pourquoi ?).

En tapant ceci : https://www.lemonde.fr/m-le-mag/article/2026/04/04/quand-les-tirets-trahissent-l-usage-de-chatgpt-il-n-a-meme-pas-fait-l-effort-de-retirer-le-tiret-cadratin_6676653_4500055.html, on obtient cela :

Et ici sous format d’image, pour conserver une trace au cas où ce problème est corrigé :

Bref, pour ma part, en Markdown, j’utilise systématiquement la syntaxe complète (URL et texte affiché) pour éviter le problème précédent (et je préfère voir l’URL sur laquelle je clique plutôt qu’une prévisualisation qui pourrait être trompeuse) :

[https://www.ctan.org](https://www.ctan.org)

plutôt que

https://www.ctan.org.

Le premier produit :

https://www.ctan.org

et le second produit :

C’est plus joli, mais uniquement lorsque cela fonctionne.

Et sur la première version on voit directement le chemin complet :

https://mirrors.ctan.org/info/tex-nutshell/tex-nutshell.pdf

comparé à

Bref, pour en revenir à ce Client Challenge, c’est plutôt bizarre, non ?

Je ne trouve pas de trace de Client Challenge sur

(toutefois l’article est réservé aux abonnés, on n’en a qu’une partie, c’est peut-être cela, le Client challenge : il faut être client du Monde pour pouvoir tout lire).

Pour l’anecdote, ces jours-ci, sur un réseau (a ?)social, quelqu’un a prétendu qu’on peut distinguer les humains des IA par le fait ou non de placer une espace entre la valeur et le symbole %. Alors que tout le monde sait ici qu’on écrit \qty{100}{\percent} avec le package siunitx.

Ce que les développeurs de Discourse ignorent, si l’on regarde ce qui s’affiche lorsqu’on insère une image :

image

Point numéro 7

Ceci me semble assez grave, j’ignore évidemment si d’autres fils de discussion sont concernés.

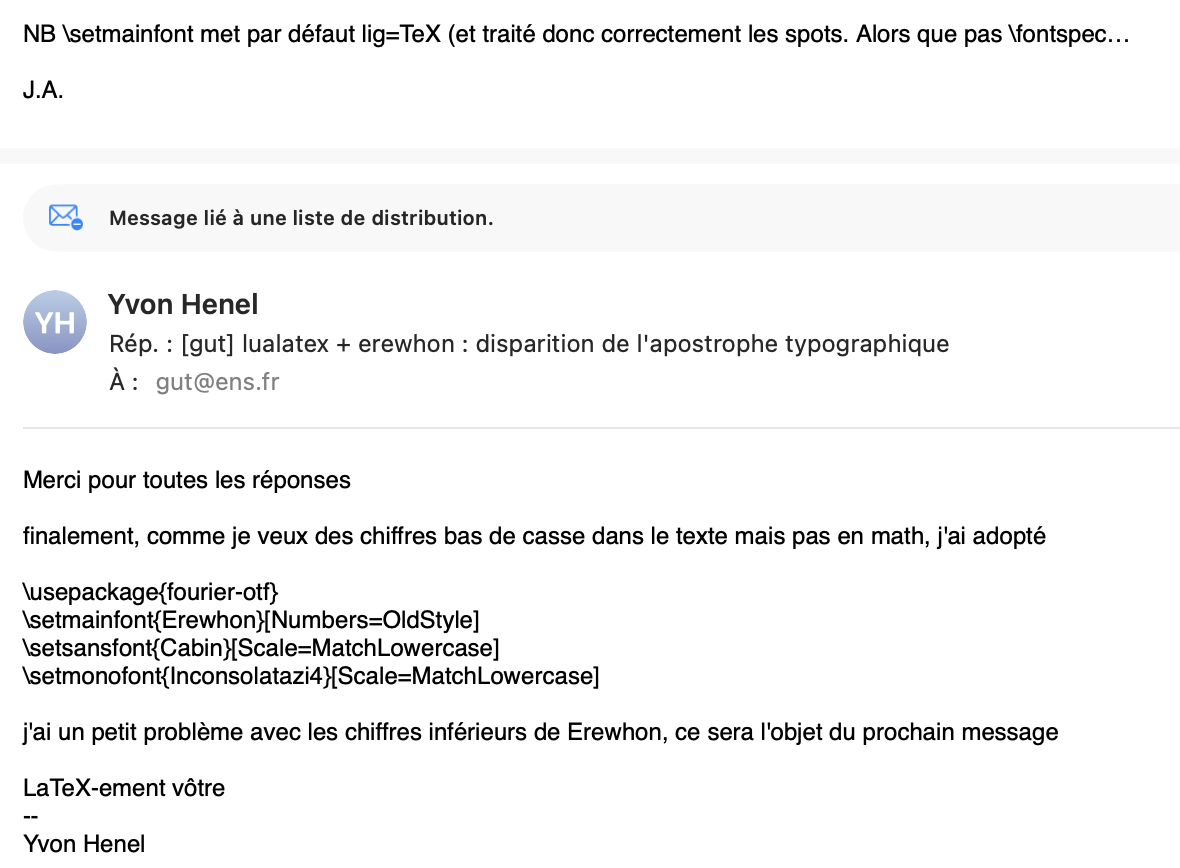
Sur le sujet suivant : https://forum.gutenberg-asso.fr/t/lualatex-erewhon-disparition-de-lapostrophe-typographique/2814, le dernier message affiché est celui de Jacques André (6e message du fil de discussion).

Or sur mon logiciel de mail, ce fil comporte un message supplémentaire, d’Yvon Henel, daté du 26 novembre 2025 à 16h38 :

Il y a deux possibilités : soit la base de mails employée pour l’importation était incomplète, soit pour une raison à déterminer, ce message-là n’a pas été inclu dans Discourse.

Il ne faut quand même pas exagérer sur la gravité. Effectivement cette réponse n’apparaît pas dans nos archives.

Mais ce ne sont pas des critiques !!!

C’est simplement pour signaler d’éventuels problèmes, au cas où une correction est nécessaire.

Edit : c’est dommage que les explications technique sur les difficultés rencontrés ont été supprimés de votre réponse. C’est (c’était ?) fort instructif (un œil extérieur ignore ces détails, il ne constate que l’absence d’un mail dans la restitution des mails de la liste GUT).

J’ajouterais qu’il faut bien distinguer deux choses. Les archives collectées par les services de l’ENS sont intégralement en possession de l’association, dans leur intégrité. Si c’était nécessaire, par exemple pour une recherche académique, nous pourrions les communiquer telles quelles dans le respect de la réglementation. La version mise en ligne est caviardée, pour la plus grande partie volontairement (adresses et numéros de téléphone), et a subi diverses altérations que nous pouvons seulement corriger au coup par coup quand il y a un véritable intérêt, c’est-à-dire quand la discussion contient des informations qui peuvent servir et que les altérations portent sur lesdites informations. Cela peut inclure d’éventuelles pièces jointes qui apportent des informations utiles : si on nous les fournit en nous disant où les ajouter, nous pouvons le faire. Ces problèmes, entendus ainsi, sont assez limité et n’affectent en rien l’intégrité des archives telles qu’elles nous ont été fournies par l’ENS ; quant au fait que l’ENS n’ait pas tout archivé, nous n’y pouvons rien, et il est d’ailleurs normal, quand on archive, de faire des choix.

On ne peut que remercier Daniel pour l’énorme travail qu’il a fourni bénévolement pendant des mois et qui a permis a ce forum et à cette version en ligne des archives d’exister. Il y a encore des imperfections que l’on corrigera bien volontiers ; nous sommes reconnaissants aux personnes qui nous les signalent et proposent parfois des solutions, mais attention à ne pas trop charger la barque !